3. 文書オブジェクトモデル
pugixmlは、DOMに似た方法でXMLデータを保存します。XML文書全体(文書構造と要素データの両方)が、ツリーとしてメモリーに保持されます。ツリーは文字ストリーム(ファイル、文字列、C++ I/Oストリーム)から読み込み、専用APIやXPath式を使って走査できます。ツリー全体は変更可能で、ノード構造もノード・属性のデータもいつでも変更できます。最後に、文書変換の結果を文字ストリーム(ファイル、C++ I/Oストリーム、独自の転送手段)に保存できます。
3.1. ツリー構造
XML文書はツリーデータ構造で表されます。ツリーのルートは文書そのもので、C++のxml_document型に対応します。文書には1個以上の子ノードがあり、それぞれC++のxml_node型に対応します。ノードにはさまざまな型があります。型によって、子ノードの集合、C++のxml_attribute型に対応する属性の集合、その他のデータ(名前など)を持ちます。
ツリーのノードは、次のいずれかの型になります。これらを合わせてxml_node_type列挙型を構成します。
-
文書ノード(
node_document)はツリーのルートで、複数の子ノードから構成されます。このノードはxml_documentクラスに対応します。xml_documentはxml_nodeのサブクラスなので、ノードのインターフェース全体も利用できます。ただし、文書ノードにはいくつかの特別な性質があり、後で説明します。ツリー内に文書ノードは1個しか存在できず、XML上の表現はありません。文書は通常、子要素ノードを1個持ちます(document_element()を参照)。ただし、XMLフラグメントから解析した文書(parse_fragmentを参照)では、複数の子要素を持つことがあります。 -
要素・タグノード(
node_element)は最も一般的なノード型で、XML要素を表します。要素ノードは名前、属性の集合、子ノードの集合を持ちます。どちらの集合も空で構いません。属性は単純な名前と値の組です。要素ノードのXML表現の例を次に示します。<node attr="value"><child/></node>ここには2個の要素ノードがあります。一方の名前は
"node"で、属性"attr"を1個、子ノード"child"を1個持ちます。もう一方の名前は"child"で、属性も子ノードも持ちません。 -
通常の文字データノード(
node_pcdata)はXML内のプレーンテキストを表します。PCDATAノードは値を持ちますが、名前、子ノード、属性は持ちません。通常の文字データは要素ノードの一部ではなく、独立したノードを持つことに注意してください。1個の要素ノードが複数のPCDATA子ノードを持つことがあります。テキストノードのXML表現の例を次に示します。<node> text1 <child/> text2 </node>ここでは、
"node"要素が3個の子ノードを持ち、そのうち2個は値が" text1 "と" text2 "のPCDATAノードです。 -
文字データノード(
node_cdata)は、特別な方法で囲まれたXML内のテキストを表します。CDATAノードは、XML上の表現を除けばPCDATAノードと違いはありません。先ほどのテキストの例をCDATAで表すと、次のようになります。<node> <![CDATA[text1]]> <child/> <![CDATA[text2]]> </node>CDATAノードを使うと、エスケープしていない
<、&、>をプレーンテキストに容易に含められます。文字列]]>はノード内容の終端を示すため、CDATAの値に含めることはできません。 -
コメントノード(
node_comment)はXML内のコメントを表します。コメントノードは値を持ちますが、名前、子ノード、属性は持ちません。コメントノードのXML表現の例を次に示します。<!-- comment text -->ここでは、コメントノードの値は
"comment text"です。既定では、コメントノードはXMLマークアップの必須でない部分として扱われ、XML解析時には読み込まれません。この動作はparse_commentsフラグで変更できます。 -
処理命令ノード(
node_pi)はXML内の処理命令(PI)を表します。PIノードは名前と省略可能な値を持ちますが、子ノードや属性は持ちません。PIノードのXML表現の例を次に示します。<?name value?>ここでは、名前(PIターゲットとも呼ばれます)は
"name"で、値は"value"です。既定では、PIノードはXMLマークアップの必須でない部分として扱われ、XML解析時には読み込まれません。この動作はparse_piフラグで変更できます。 -
宣言ノード(
node_declaration)はXML内の文書宣言を表します。宣言ノードは名前("xml")と省略可能な属性の集合を持ちますが、値や子ノードは持ちません。文書内に宣言ノードは1個しか存在できず、最上位のノードであるべきです(親は文書であるべきです)。宣言ノードのXML表現の例を次に示します。<?xml version="1.0"?>ここでは、ノードの名前は
"xml"で、名前が"version"、値が"1.0"の属性を1個持ちます。既定では、宣言ノードはXMLマークアップの必須でない部分として扱われ、XML解析時には読み込まれません。この動作はparse_declarationフラグで変更できます。また、既定では、XML文書の保存時に文書内に宣言がなければ仮の宣言が出力されます。この動作はformat_no_declarationフラグで無効にできます。 -
文書型宣言ノード(
node_doctype)はXML内の文書型宣言を表します。文書型宣言ノードは、文書型の内容全体に対応する値を持ちます。<!ENTITY>のような内部要素のために追加のノードは作られません。文書内に文書型宣言ノードは1個しか存在できず、最上位のノードであるべきです(親は文書であるべきです)。文書型宣言ノードのXML表現の例を次に示します。<!DOCTYPE greeting [ <!ELEMENT greeting (#PCDATA)> ]>ここでは、ノードの値は
"greeting [ <!ELEMENT greeting (#PCDATA)> ]"です。既定では、文書型宣言ノードはXMLマークアップの必須でない部分として扱われ、XML解析時には読み込まれません。この動作はparse_doctypeフラグで変更できます。
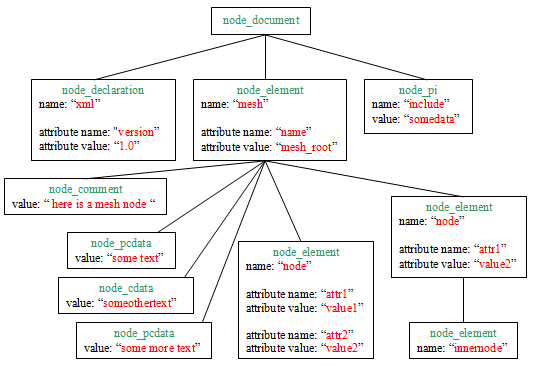
最後に、XML文書全体の例と、それに対応するツリー表現を示します(samples/tree.xml)。
|
|
3.2. C++インターフェース
注記
|
pugixmlのすべてのクラスと関数はpugi名前空間にあります。明示的に名前を修飾する(例:pugi::xml_node)か、using指令を使って必要なシンボルにアクセスできるようにする(例:using pugi::xml_node;またはusing namespace pugi;)必要があります。この文書では、以降のすべての宣言で名前空間を省略します。すべてのコード例では完全修飾名を使います。 |
ノード型はいくつもありますが、ツリーを表すC++クラスはxml_document、xml_node、xml_attributeの3つだけです。xml_nodeに対する操作の中には、特定のノード型でのみ有効なものがあります。これらのクラスについて、次に説明します。
xml_documentは文書構造全体の所有者で、コピーできないクラスです。xml_documentのインターフェースには、読み込み関数(文書の読み込みを参照)、保存関数(文書の保存を参照)、文書の調査や変更に使えるxml_nodeのインターフェース全体が含まれます。xml_documentはxml_nodeのサブクラスですが、xml_nodeはポリモーフィックな型ではないことに注意してください。継承は使い方を簡単にするためだけに用いられています。あるいは、document_element関数で、文書の直接の子である要素ノードを取得できます。
xml_documentのデフォルトコンストラクターは、ルートノード(文書ノード)だけを持つツリーとして文書を初期化します。その後、ツリーの変更関数や読み込み関数でデータを追加できます。すべての読み込み関数は、以前のツリーとその使用メモリー全体を破棄するため、その文書の既存のノード・属性ハンドルは無効になります。以前のツリーを破棄したい場合は、xml_document::reset関数を使えます。この関数はツリーを破棄し、空のツリーか指定した文書のコピーで置き換えます。xml_documentのデストラクターもツリーを破棄します。そのため、文書オブジェクトの寿命は、ツリーを指すノード・属性ハンドルの寿命より長くあるべきです。
注意
|
技術的には、参照先のツリーを破棄した後もノード・属性ハンドルは存在できますが、そのハンドルのメンバー関数を呼び出すと未定義動作になります。そのため、ノード・属性へのすべての参照が破棄された後にのみ文書を破棄することを推奨します。 |
xml_nodeは文書ノードへのハンドルで、文書ノードそのものを含む、文書内のどのノードも指せます。すべての型のノードに共通のインターフェースがあり、実際のノード型はxml_node::type()メソッドで調べられます。xml_nodeは実際のノードへのハンドルにすぎず、ノードそのものではありません。同じ実体を指すxml_nodeハンドルが複数あっても構いません。xml_nodeハンドルを破棄しても、ノードは破棄されず、ツリーからも削除されません。xml_nodeのサイズはポインターのサイズと等しく、ポインターを包む軽量なラッパーにすぎません。そのため、追加のオーバーヘッドなしに、xml_nodeオブジェクトを値で安全に渡したり返したりできます。
xml_node型には、nullノードまたは空ノードと呼ばれる特別な値があります。このようなノードの型はnode_nullです。どの文書のどのノードにも対応せず、nullポインターに似ています。ただし、空ノードに対してもすべての操作が定義されています。通常、これらの操作は何もせず、空のノード・属性や空文字列を返します。詳しくは個々の関数の文書を参照してください。これは呼び出しを連鎖させるときに便利です。たとえば、ノードの祖父ノードはnode.parent().parent()で取得できます。ノードがnullノードであるか親を持たない場合、最初のparent()はnullノードを返し、2回目のparent()もnullノードを返すため、エラー処理が簡単になります。
xml_attributeはXML属性へのハンドルで、xml_nodeと同じ意味論を持ちます。つまり、同じ実体を指すxml_attributeハンドルが複数あっても構わず、関数の結果にも伝わる特別なnull属性の値があります。
xml_nodeとxml_attributeには、どちらにもnullオブジェクトとして初期化するデフォルトコンストラクターがあります。
xml_nodeとxml_attributeはポインターのように振る舞おうとします。つまり、同じ型のほかのオブジェクトと比較できるため、連想コンテナーのキーとして使えます。同じ実体を指すすべてのハンドルは等しく、異なる実体を指す2つのハンドルは等しくありません。nullハンドルは、nullハンドルとの比較でのみ等しいと判定されます。大小比較の結果は、ファイル内のノードの順序やその他の方法から確実に決定することはできません。検索の最適化(連想コンテナーのキーなど)以外には、大小比較演算子を使わないでください。
ハッシュに基づく連想コンテナーのキーとしてxml_nodeやxml_attributeオブジェクトを使いたい場合は、hash_valueメンバー関数を使えます。同じ実体を指すすべてのハンドルについて、同じ値になることが保証されたハッシュ値を返します。nullハンドルのハッシュ値は0です。ハッシュ値はノードの内容ではなく、実体の構造がメモリー内にある位置だけに依存します。このため、同じ文書を2回読み込むと異なるハッシュ値になる可能性が高く、ノードをコピーしてもハッシュ値は保持されません。
最後に、ハンドルはboolに似たオブジェクトへ暗黙に変換できるため、ノードや属性が空かどうかをif (node) { … }やif (!node) { … } else { … }で調べられます。あるいは、次のメソッドを呼び出して、指定したxml_nodeやxml_attributeハンドルがnullかどうかを確認できます。
bool xml_attribute::empty() const;
bool xml_node::empty() const;ノードや属性は文書ツリーなしでは存在できないので、いずれかの文書へ追加せずに作成することはできません。ノード・属性の実体が破棄されると、その実体へのハンドルは無効になります。ツリー全体の破棄で、すべてのノード・属性ハンドルが無効になるだけでなく、部分木の破棄(xml_node::remove_childの呼び出し)や属性の削除でも、対応するハンドルは無効になります。ハンドルが有効かどうかを確認する方法はないため、外部の仕組みで正しさを保証しなければなりません。
3.3. Unicodeインターフェース
pugixmlの設定では、インターフェースと内部表現を2種類から選べます。UTF-8インターフェース(charインターフェースとも呼ばれます)か、UTF-16/32インターフェース(wchar_tインターフェースとも呼ばれます)です。選択はPUGIXML_WCHAR_MODEの定義で制御します。追加の設定オプションで説明したように、pugiconfig.hppまたはプリプロセッサーのオプションで設定できます。この定義を設定するとwchar_tインターフェースが使われ、それ以外の場合は既定のcharインターフェースが使われます。ワイド文字のエンコーディングはUTF-16かUTF-32と仮定され、wchar_t型のサイズに基づいて決まります。
注記
|
wchar_tのサイズが2の場合、pugixmlはUCS-2ではなくUTF-16エンコーディングと仮定します。そのため、一部の文字は2つのコードポイントで表されます。 |
文字列を扱うすべてのツリー関数は、選択した文字型のC形式のnull終端文字列、またはSTL文字列を扱います。たとえば、ノード名のアクセサーはcharモードでは次のようになります。
const char* xml_node::name() const;
bool xml_node::set_name(const char* value);
wchar_tモードでは、次のようになります。
const wchar_t* xml_node::name() const;
bool xml_node::set_name(const wchar_t* value); 文字型として定義され、ライブラリの設定に依存する特別な型pugi::char_tがあります。以降の文書でもこの型を使います。また、文字型のSTL文字列として定義されるpugi::string_t型もあります。charモードではstd::string、wchar_tモードではstd::wstringに対応します。同様に、string_view_tはstd::basic_string_view<char_t>として定義されます。string_view_tのオーバーロードは、C++17以降を対象にビルドするときにだけ利用できます(PUGIXML_HAS_STRING_VIEWを参照)。
インターフェースに加えて、内部実装もXMLデータをpugi::char_tとして保存するように変わります。そのため、この2つのモードではメモリー使用量の特性が異なります。一般に、UTF-8モードの方がメモリーと性能の面で効率的で、特にsizeof(wchar_t)が4の場合に顕著です。文書読み込み時のpugi::char_tへの変換と、文書保存時のpugi::char_tからの変換は自動で行われますが、多少の性能上の負担もあります。ただし、一般的には使用場面に基づいて文字モードを選ぶことを勧めます。たとえばUTF-8を処理しにくく、XMLデータの大半が非ASCIIの場合は、wchar_tモードの方が適しているでしょう。
UTF-8とwchar_tのエンコーディングの間で文字列データを変換しなければならない場合があります。このために、次の補助関数が用意されています。
std::string as_utf8(const wchar_t* str);
std::wstring as_wide(const char* str);どちらの関数も、引数strにnull終端文字列を受け取り、変換した文字列を返します。as_utf8はUTF-16/32からUTF-8へ、as_wideはUTF-8からUTF-16/32へ変換します。不正なUTFシーケンスは、変換時に通知せず破棄されます。strは有効な文字列でなければならず、nullポインターを渡すと未定義動作になります。また、同じ意味論を持ち、引数に文字列を受け取るオーバーロードが2つあります。
std::string as_utf8(const std::wstring& str);
std::wstring as_wide(const std::string& str);
注記
|
この文書の例の大半はcharインターフェースを前提にしているため、PUGIXML_WCHAR_MODEではコンパイルできません。これは文書を簡潔にするためです。通常、必要な変更は
次のコードを使う必要があります。
|
3.4. スレッド安全性の保証
pugixmlのほぼすべての関数には、次のスレッド安全性の保証があります。
-
非メンバーの自由関数は、複数のスレッドから呼び出しても安全です。
-
同じツリーに対する並行した読み取り専用アクセスは安全です。constメンバー関数はすべてツリーを変更しません。
-
複数のツリーに対する並行した読み書きは、各ツリーに同時にアクセスするスレッドが1つだけであれば安全です。
1つのツリーに対する並行した読み書きには、読み書きロックなどによる同期が必要です。変更には、文書構造の変更と、個々のノード・属性のデータの変更(名前や値の変更など)が含まれます。
唯一の例外はset_memory_management_functionsです。この関数はグローバル変数を変更するため、スレッドセーフではありません。使用方針にはさらに制約があります。独自のメモリー割り当て・解放関数を参照してください。
3.5. 例外保証
XPathを除けば、pugixml自体は例外を送出しません。さらに、pugixmlのほとんどの関数は、例外を送出しないことを保証します。
この保証は、STL文字列やIOstreamを扱う関数には当てはまりません。これらの関数には、強い保証(文字列を扱う関数)か基本保証(ストリームを扱う関数)があります。また、ユーザー定義のコールバックを呼び出す関数(xml_node::traverseやxml_node::find_nodeなど)は、コールバック自体が提供する以上の例外保証を提供しません。
PUGIXML_NO_EXCEPTIONSの定義で例外処理を無効にしていなければ、XPath関数は解析エラー時にxpath_exceptionを送出することがあります。また、メモリー不足時にはstd::bad_allocを送出することがあります。それでも、XPath関数は強い例外保証を提供します。
3.6. メモリー管理
pugixmlは、文書を保持するためのメモリーを大きなチャンクで要求し、そのチャンク内に文書データを割り当てます。この節では、チャンクの割り当てに使う関数の置き換えと、内部のメモリー管理実装について説明します。
3.6.1. 独自のメモリー割り当て・解放関数
ツリー構造、ツリーのデータ、XPathオブジェクトのメモリーはすべて、グローバルに指定された関数で割り当てられます。既定ではmalloc/freeです。set_memory_management_functions関数で、独自の割り当て関数を設定できます。関数のインターフェースはmalloc/freeと同じです。
typedef void* (*allocation_function)(size_t size);
typedef void (*deallocation_function)(void* ptr);
次のアクセサー関数を使って、現在のメモリー管理関数を変更したり取得したりできます。
void set_memory_management_functions(allocation_function allocate, deallocation_function deallocate);
allocation_function get_memory_allocation_function();
deallocation_function get_memory_deallocation_function();割り当て関数は、サイズ(バイト単位)を引数として呼び出されます。基本型の格納に適したアラインメント(通常はvoid*型とdouble型のアラインメントの大きい方で十分)を持ち、要求したサイズ以上のメモリーブロックへのポインターを返すべきです。割り当てに失敗した場合は、nullポインターを返すか、例外を送出しなければなりません。
解放関数は、割り当て関数の呼び出しで返されたポインターを引数として呼び出されます。nullポインターで呼び出されることはありません。メモリー管理関数がスレッドセーフでない場合、ライブラリのスレッド安全性は保証されません。
独自のメモリー管理の簡単な例です(samples/custom_memory_management.cpp)。
void* custom_allocate(size_t size)
{
    return new (std::nothrow) char[size];
}

void custom_deallocate(void* ptr)
{
    delete[] static_cast<char*>(ptr);
}pugi::set_memory_management_functions(custom_allocate, custom_deallocate);新しいメモリー管理関数を設定するときは、有効なpugixmlオブジェクトが残っていないことを確認してください。そうしないと、オブジェクトの破棄時に、古い割り当て関数で取得したメモリーを新しい解放関数へ渡すことになり、未定義動作が生じます。
3.6.2. メモリー消費の調整
pugixmlには、あらかじめ定義された定数に依存する、重要なバッファーの最適化がいくつかあります。これらの定数の既定値は、一般的な使用パターンに合わせて調整されています。アプリケーションによっては、定数を変更するとメモリー消費や性能が改善することがあります。既定値が目に見える問題を引き起こしていない限り、変更は推奨しません。
これらの定数は、追加の設定オプションで説明した設定用の定義で調整できます。pugiconfig.hppで設定することを推奨します。
-
PUGIXML_MEMORY_PAGE_SIZEは、文書のメモリー割り当てに使うページサイズを制御します。ノード・属性の実体のメモリーは、指定したサイズのページに割り当てられます。既定のサイズは32 Kbです。アプリケーションによっては、このサイズが大きすぎます。たとえば、ヒープが小さい組み込みシステムや、多数のXML文書をメモリー内に保持するアプリケーションです。最小サイズとして1 Kbを推奨します。 -
PUGIXML_MEMORY_OUTPUT_STACKは、ノードの出力に必要なスタック領域の合計を制御します。すべての出力操作(部分木のファイルへの保存など)は、性能上の理由から内部でバッファリングを行います。既定のサイズは10 Kbです。スタック領域の小さいスレッドからノードを出力する場合、この値を小さくするとスタックオーバーフローを防げます。最小サイズとして1 Kbを推奨します。 -
PUGIXML_MEMORY_XPATH_PAGE_SIZEは、XPathのメモリー割り当てに使うページサイズを制御します。XPathクエリーオブジェクトのメモリーとXPath評価用の内部メモリーは、指定したサイズのページに割り当てられます。既定のサイズは4 Kbです。多数のXPathクエリーオブジェクトを常時保持する場合は、メモリー消費を改善するためにサイズを小さくする必要があるかもしれません。最小サイズとして256バイトを推奨します。
3.6.3. 文書メモリー管理の内部構造
デフォルトコンストラクターで文書オブジェクトを構築しても、メモリーの割り当ては発生しません。文書ノードはxml_documentオブジェクト内に保存されます。
ファイルやバッファから文書を読み込むときは、インプレース読み込み関数を使わない限り(メモリーからの文書の読み込みを参照)、文字ストリーム全体のコピーが作られます。ノードと属性の名前・値は、すべてこのバッファ内に割り当てられます。このバッファは1回の大きな割り当てで取得され、文書のメモリーを回収するときにだけ解放されます。たとえば、xml_documentオブジェクトを破棄する場合や、同じオブジェクトに別の文書を読み込む場合です。また、ファイルやストリームから読み込むときにエンコーディング変換が必要であれば、追加の大きな割り当てが行われることがあります。一時バッファが割り当てられ、読み込み関数が戻る前に解放されます。
文書構造(ノード・属性の実体)やノード・属性の名前・値などの追加メモリーは、すべて約32 Kbのページに割り当てられます。実際のオブジェクトは、多数の小さいオブジェクトの高速な割り当て・解放に最適化されたメモリー管理方式で、ページ内に割り当てられます。この方式の性質上、ページは内部のすべてのオブジェクトが破棄された場合にだけ破棄されます。また一般に、あるオブジェクトを破棄しても、その後に作成するオブジェクトが同じメモリーを再利用するとは限りません。このため、予想より多くのメモリーを使う使用方法を考案することはできます。たとえば大量のノードを追加し、その後で偶数番目のノードをすべて削除しても、ページは1つも回収されません。ただし、これは不都合な動作を起こすように特に作られた例です。実際のあらゆる使用場面では、割り当てのメタデータが非常に小さいため、メモリー消費は汎用アロケーターより少なくなります。
3.6.4. コンパクトモード
既定では、ノードと属性はアクセス効率を重視して最適化されています。このため、大量のメモリーを使うことがあります。ノードが多く内容が少ない文書(属性値やノードのテキストが短い文書)では、ポインターサイズによっては、文書構造が文書そのものより明らかに多くのメモリーを使うことがあります。たとえば、64ビットプラットフォームのUTF-8モードでは、ファイルサイズが2.1 Mbのマークアップの多い文書が、文書バッファに2.1 Mb、文書構造に8.3 Mbを使う場合があります。
大きな文書を処理する場合や、プラットフォームのメモリーが限られていて、メモリーのために多少の性能を犠牲にできる場合は、PUGIXML_COMPACTを定義してpugixmlをコンパイルし、コンパクトモードを有効にできます。コンパクトモードは、ノードと属性の間の参照の局所性を仮定した別の文書構造表現を使い、メモリー使用量を最適化します。その結果、ノード・属性の実体は大幅に小さくなります。通常は、多くの文書のほとんどの実体について追加の保存領域は不要ですが、最悪の場合、つまり参照の局所性の仮定が成り立たない場合には、必要な追加データを保存するためのメモリーが別途割り当てられます。
コンパクトな格納方式は、ツリーの変更を含む既存のすべての操作を、同じ償却計算量でサポートします。つまり、基本的な文書操作はすべて、平均では引き続きO(1)です。操作は少し遅くなり、処理がメモリー性能に制約されていない限り、通常、処理時間では10〜50%の低速化が見込まれます。
32ビットアーキテクチャでは、コンパクトモードの文書構造は通常、元の約1/2.5になります。64ビットアーキテクチャでは約1/5です。このため、マークアップの多い大きな文書では、コンパクトモードによって、数ギガバイトの文書をRAMだけで処理できるか、ディスクへのスワップが必要かが変わることがあります。文書がメモリーに収まる場合でも、コンパクトな格納方式は領域を減らし、キャッシュやTLBのミスを減らすことでCPUキャッシュを効率よく使えます。