xxHash — 非常に高速なハッシュアルゴリズム
ウェブサイト · APIドキュメント · xxhsumマニュアル · 形式仕様
xxHashは、RAMの速度限界に達するほど高速な非暗号学的ハッシュアルゴリズムです。移植性が高く、リトルエンディアンとビッグエンディアンを含む、あらゆるプラットフォームで同一のハッシュを生成します。アルゴリズムが確定すると、その出力はxxHashのリリースをまたいでも変わりません。
このライブラリには次のアルゴリズムが含まれます。
- XXH32は32ビット演算を使って32ビットのハッシュを生成します。
- XXH64は64ビット演算を使って64ビットのハッシュを生成します。
- v0.8.0以降で利用できるXXH3は、ベクトル演算を使って64ビットまたは128ビットのハッシュを生成します。128ビット版はXXH128と呼ばれます。
新しいアプリケーションでは、標準の選択としてXXH3_64bits()を推奨します。128ビットのハッシュが必要な場合はXXH3_128bits()を使用してください。
ベンチマーク
ベンチマークの基準システムは、Ubuntu x64 20.04を実行するIntel i7-9700K CPUです。オープンソースのベンチマークプログラムは、Clang v10.0と-O3でコンパイルしています。
| ハッシュ名 | ビット幅 | 帯域幅 | 小さいデータの処理速度 | コメント |
|---|---|---|---|---|
| XXH3 (AVX2) | 64 | 59.4 GB/s | 133.1 | |
| XXH128 (AVX2) | 128 | 57.9 GB/s | 118.1 | |
| XXH3 (SSE2) | 64 | 31.5 GB/s | 133.1 | |
| XXH128 (SSE2) | 128 | 29.6 GB/s | 118.1 | |
| RAMからのmemcpy | N/A | 28.0 GB/s | N/A | 参考値 |
| City64 | 64 | 22.0 GB/s | 76.6 | |
| T1ha2 | 64 | 22.0 GB/s | 99.0 | 衝突特性がやや劣る |
| City128 | 128 | 21.7 GB/s | 57.7 | |
| XXH64 | 64 | 19.4 GB/s | 71.0 | |
| SpookyHash | 64 | 19.3 GB/s | 53.2 | |
| Mum | 64 | 18.0 GB/s | 67.0 | 衝突特性がやや劣る |
| XXH32 | 32 | 9.7 GB/s | 71.9 | |
| City32 | 32 | 9.1 GB/s | 66.0 | |
| Murmur3 | 32 | 3.9 GB/s | 56.1 | |
| SipHash | 64 | 3.0 GB/s | 43.2 | |
| FNV64 | 64 | 1.2 GB/s | 62.7 | アバランシェ特性が弱い |
| Blake2 | 256 | 1.1 GB/s | 5.1 | 暗号学的 |
| SHA1 | 160 | 0.8 GB/s | 5.6 | 暗号学的だが破られている |
| MD5 | 128 | 0.6 GB/s | 7.8 | 暗号学的だが破られている |
ほかのプラットフォームでの現在の測定結果は、xxhash.comのベンチマークを参照してください。
注1:小さいデータの処理速度は、小さいデータに対するアルゴリズムの効率をおおまかに評価したものです。詳しい分析は次の節を参照してください。
注2:一部のアルゴリズムはRAMよりも高速です。入力がすでにCPUキャッシュ(L3以上)にある場合に限って、最大限の速度を発揮できます。それ以外の場合はRAMの速度が上限になります。
小さいデータ
大きいデータでの性能は、全体像の一部にすぎません。ハッシュ処理は、ハッシュテーブルやブルームフィルターなどの構造でも非常に役立ちます。こうした用途では、多数の小さい入力をハッシュすることが一般的で、入力が数バイトしかないこともあります。この場合、初期化と終了処理のコストが固定的にかかるため、アルゴリズムの性能は大きく異なり得ます。分岐予測の失敗も、はるかに大きな影響を及ぼします。
XXH3は、長い入力でも小さい入力でも優れた性能を発揮するよう設計されています。次のグラフでその様子を確認できます。
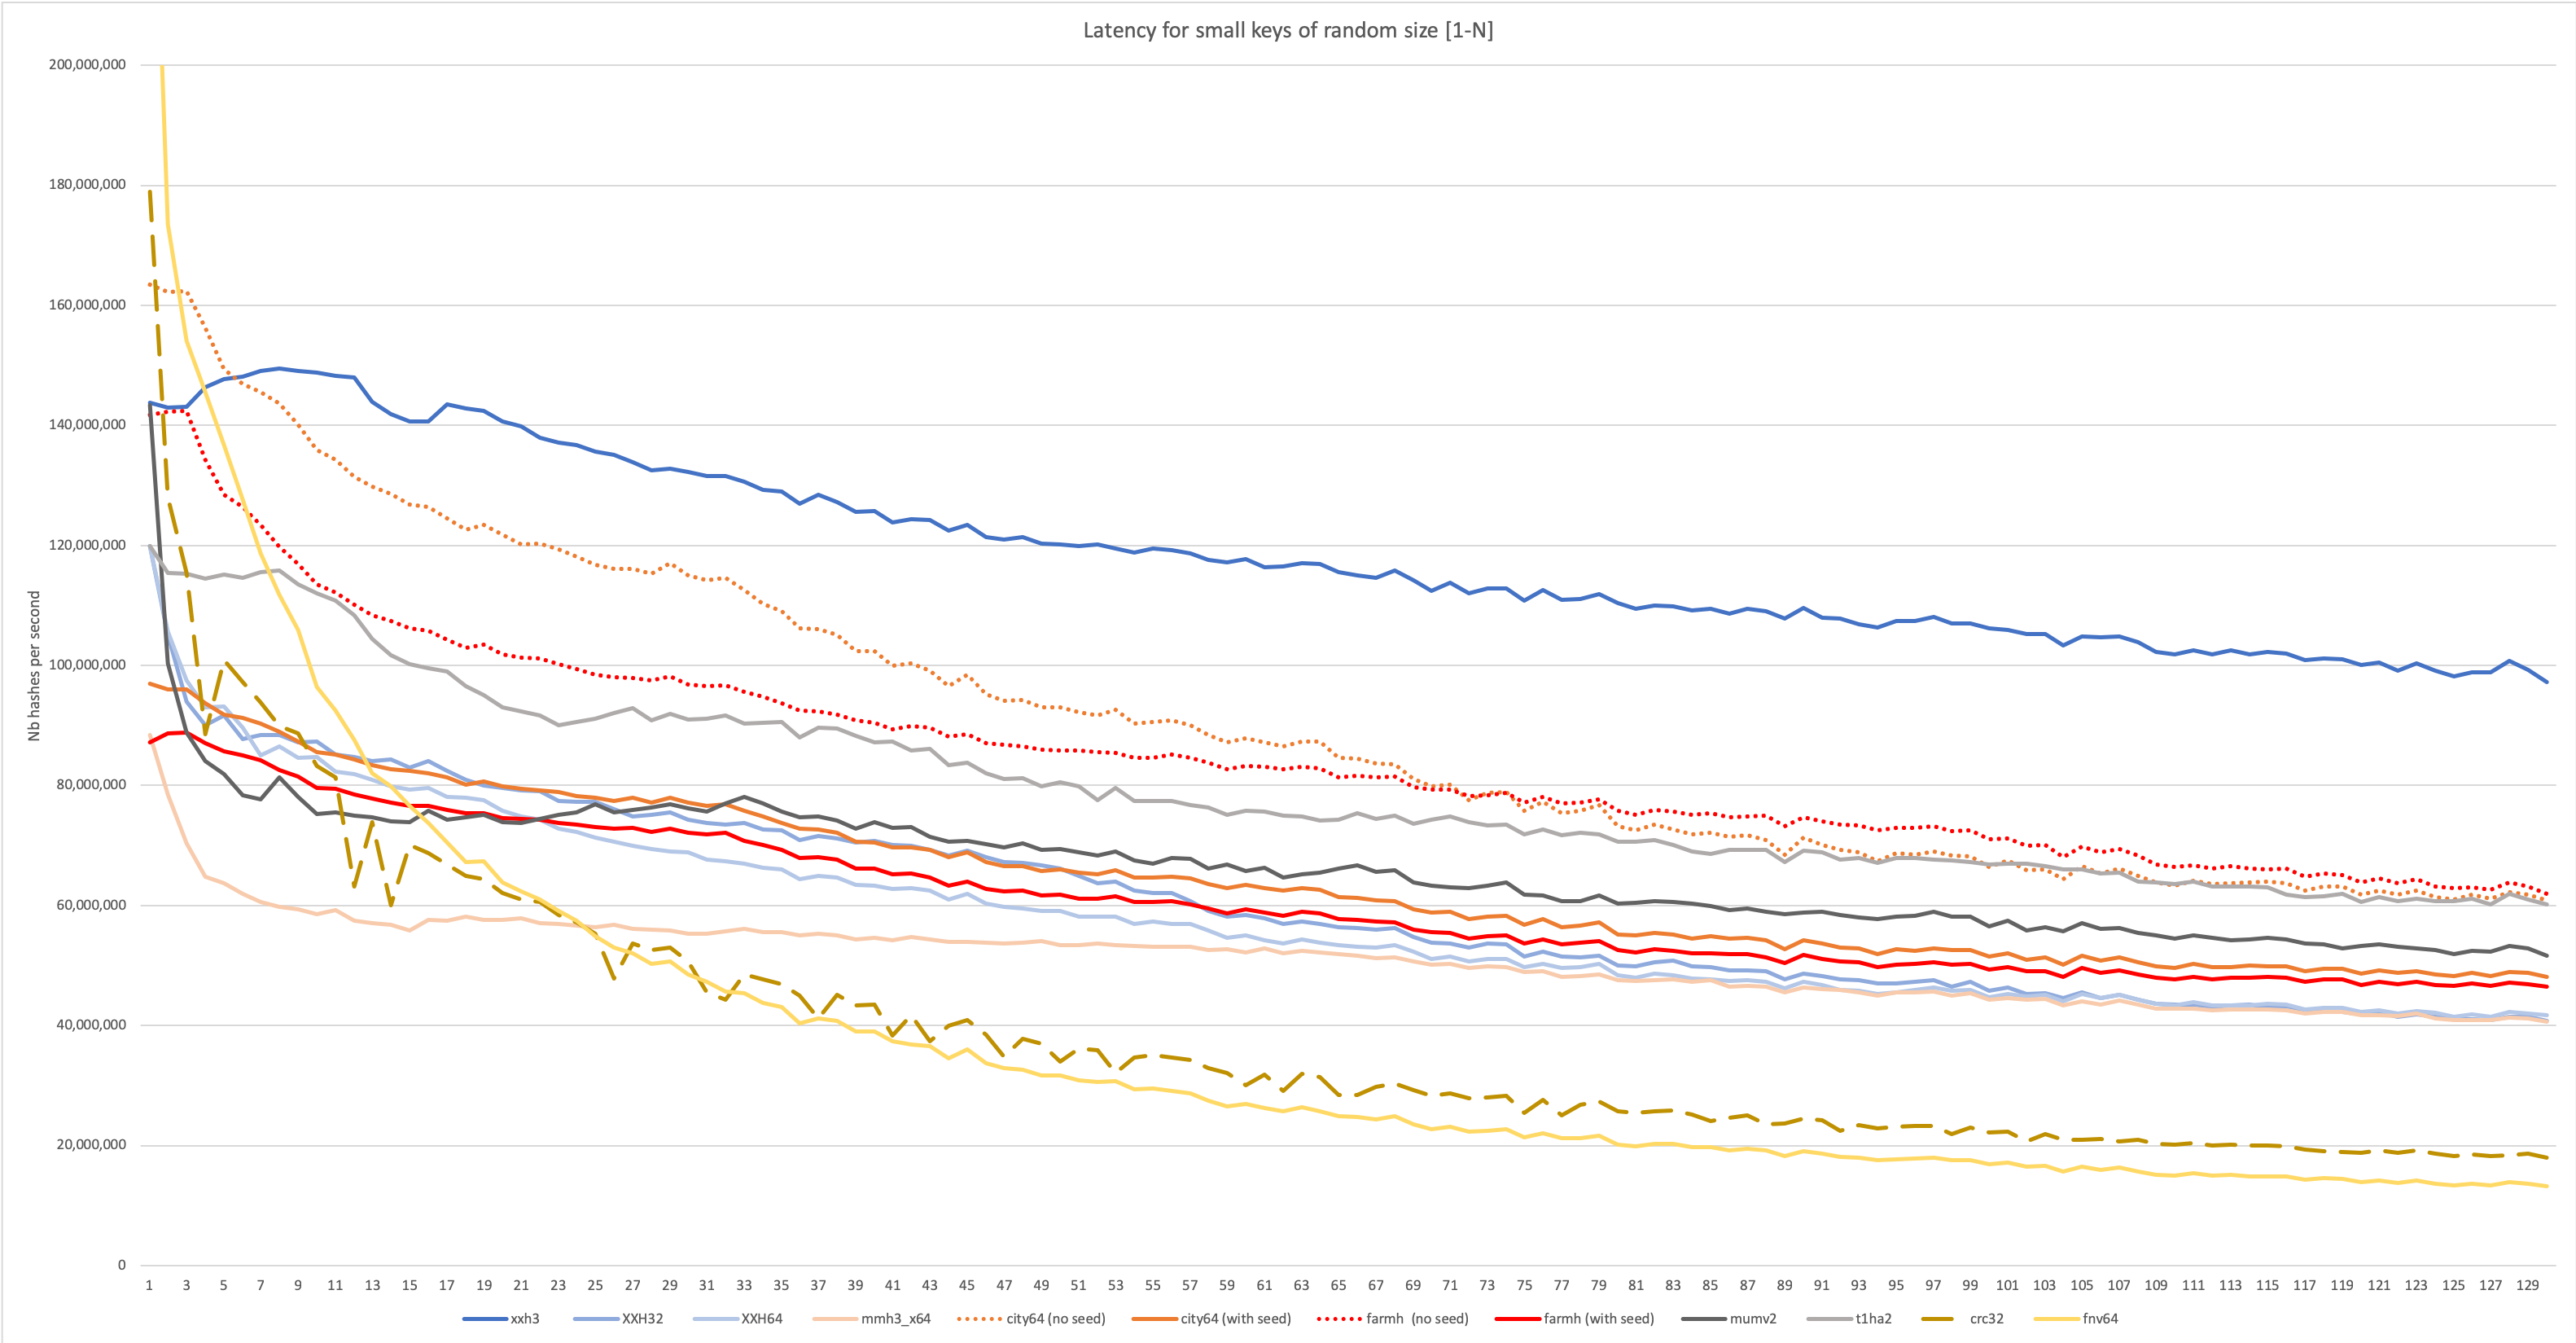
詳しい分析は、wikiの性能比較を参照してください。
xxHashは暗号学的ハッシュ関数ではありません。 署名、パスワードの保存、その他の攻撃への耐性が必要な用途には使用しないでください。
| ブランチ | 状態 |
|---|---|
| release |  |
| dev |  |
使い始める
デフォルトのmakeターゲットは、ライブラリとコマンドラインユーティリティxxhsumの両方をビルドします。
make
./xxhsum -H3 README.mdその後、ライブラリをlibxxhashとしてリンクするか、xxhash.cから直接コンパイルできます。ヘッダーだけで組み込むには、xxhash.hをインクルードする前にXXH_INLINE_ALLを定義します。
#define XXH_INLINE_ALL
#include "xxhash.h"CMakeでの組み込みは、CMakeガイドを参照してください。xxhsumマニュアルでは、チェックサムの生成、検証、ベンチマーク、高度なコマンドラインオプションを説明しています。
例
最も単純なAPIは、連続したメモリブロックを1回の呼び出しでハッシュします。
#include <stddef.h>
#include "xxhash.h"

XXH64_hash_t hash_buffer(const void* buffer, size_t size)
{
    return XXH3_64bits(buffer, size);
}APIは、サイズが不明なストリームの逐次的なハッシュ処理にも対応しています。1回の呼び出しとストリーミングの完全な例は、説明付きのAPIヘッダーにあります。
品質
重要なのは速度だけではありません。攻撃を意図しない入力に対し、xxHashは均一な分布を目指しています。これにより、出力ビットの任意の部分集合を使って、テーブルやインデックス内の要素を均等に分散できます。固定幅のハッシュである以上、衝突や誕生日のパラドックスの影響は受けます。
すべてのバリアントは、Austin ApplebyのSMHasherテストスイートを正常に完了しています。これは統計的な品質を測る基準となります。速度や衝突特性をより詳しく評価する追加テストも提供されています。
さらにxxHashは、独自の大規模な衝突テスターを提供しています。数十億個のハッシュを生成・比較し、64ビットハッシュアルゴリズムの限界を検証できます。この面でも、xxHashは誕生日のパラドックスと整合する良好な結果を示しています。詳しい分析はwikiに記載されています。
パッケージ
xxHashは多くのパッケージマネージャーから利用できます。vcpkgでは、次のコマンドでライブラリをインストールします。
vcpkg install xxhashコマンドラインユーティリティもインストールするには、xxhsum機能を追加します。
vcpkg install "xxhash[xxhsum]"各ディストリビューションで現在利用できるパッケージのバージョンは、Repologyで追跡されています。

高度なビルドオプション
ライブラリのマクロ
次のマクロは、コンパイル時に設定してlibxxhashの動作を変更できます。通常、デフォルトでは無効です。
XXH_INLINE_ALL:すべての関数をinlineにし、実装をxxhash.hに直接含めます。関数のインライン化は速度向上に役立ち、特に小さいキーで効果があります。キーの長さがコンパイル時定数で表される場合は非常に効果的で、+200%程度の性能向上が観測されています。詳しくはこの記事を参照してください。XXH_PRIVATE_API:XXH_INLINE_ALLと同じ結果になります。従来との互換性のため引き続き利用できます。この名前は、XXH_*というシンボル名がエクスポートされないことを強調しています。XXH_STATIC_LINKING_ONLY:静的確保に必要な内部状態の宣言にアクセスできるようにします。ABI変更のリスクがあるため、動的リンクとは互換性がありません。XXH_NAMESPACE:すべてのシンボルにXXH_NAMESPACEの値を接頭辞として付けます。このマクロにはコンパイル可能な文字集合しか使えません。xxHashのソースコードを複数回取り込む場合などに、シンボル名の衝突を避けるのに役立ちます。xxhash.hを通じてシンボルが自動的に変換されるため、クライアントアプリケーションでは通常の関数名を使います。XXH_FORCE_ALIGN_CHECK:入力がアラインされている場合に、より高速な直接読み取り経路を使います。アラインされていないアドレスからメモリをロードできないアーキテクチャでは、ハッシュ対象の入力が偶然32ビットまたは64ビット境界にアラインされている場合に、性能が大幅に改善することがあります。アラインされていないメモリアクセスの性能が高いプラットフォーム(アラインの有無にかかわらず同じ命令を使用)では、わずかに性能を悪化させます。このオプションはx86、x64、aarch64では自動的に無効になり、それ以外のすべてのプラットフォームでは有効になります。XXH_FORCE_MEMORY_ACCESS:デフォルトの方式0は、移植性のあるmemcpy()記法を使います。方式1はgcc固有のpacked属性を使い、一部の対象で性能を改善することがあります。方式2は非アライン読み取りを強制します。標準には準拠しませんが、より高い読み取り性能を得る唯一の方法になる場合もあります。方式3はバイトシフト演算を使います。memcpy()をインライン化しない古いコンパイラーや、バイトスワップ命令のないビッグエンディアンシステムに適しています。XXH_CPU_LITTLE_ENDIAN:デフォルトでは、コンパイル時に解決される実行時テストによってエンディアンを判定します。何らかの理由でコンパイラーがこの実行時テストを簡略化できない場合、性能上のコストがかかることがあります。このマクロを1に設定してアーキテクチャがリトルエンディアンだと明示すれば、自動検出を省略できます。0にするとビッグエンディアンを示します。XXH_ENABLE_AUTOVECTORIZE:CPUのベクトル機能やコンパイラーのバージョンによっては、XXH32とXXH64で自動ベクトル化が行われることがあります。注:最近のclangでは自動ベクトル化がより起こりやすい傾向があります。XXH32ではSSE4.1または同等の機能(NEON)で十分ですが、XXH64にはAVX512が必要です。残念ながら、自動ベクトル化は一般にXXHの性能を悪化させます。このため、xxhashのソースコードはデフォルトで自動ベクトル化を防ぐようにしています。ただし、システムは進歩しており、この結論は変わる可能性があります。たとえば、最近のZen4 CPUではベクトル化によって性能が改善する可能性が高いと報告されています。そのため、ベクトル化したコードを使いたい、または試したい場合は、このフラグを有効にできます。これによりベクトル化を防ぐコードが取り除かれ、XXH32とXXH64が自動ベクトル化される可能性が高まります。XXH32_ENDJMP:XXH32の複数分岐による終了処理段階を、1回のジャンプに置き換えます。一般に性能面では望ましくなく、特にランダムなサイズの入力をハッシュする場合に不利です。ただし、アーキテクチャやコンパイラーによっては、ジャンプによって小さい入力での性能がわずかに改善することがあります。デフォルトでは無効です。XXH_IMPORT:MSVC固有です。リンクエラーを防ぐため、動的リンクの場合だけ定義すべきです。XXH_NO_STDLIB:<stdlib.h>の関数、特にmalloc()とfree()の呼び出しを無効にします。libxxhashのXXH*_createState()は常に失敗してNULLを返すようになります。ただし、XXH32()などによる1回のハッシュ処理や、静的に確保した状態を使うストリーミングは、従来どおり動作します。このビルドフラグは、動的確保を使わない組み込み環境で役立ちます。XXH_memcpy、XXH_memset、XXH_memcmp:コンパイル時にmemcpy()、memset()、memcmp()をユーザーが選んだシンボルへ転送します。3つすべてを転送すると、標準ライブラリの<string.h>をインクルードする必要がなくなります。XXH_NO_EXTERNC_GUARD:xxhash.hをC++モードでコンパイルするとき、extern "C" { .. }のブロックガードを取り除きます。XXH_DEBUGLEVEL:1以上の値に設定すると、assert()文を有効にします。実行速度はわずかに低下しますが、デバッグ時のバグ発見に役立つことがあります。
バイナリーサイズの制御
XXH_NO_XXH3:生成するバイナリーから、XXH3に関連するシンボル(64ビットと128ビットの両方)を取り除きます。libxxhashのサイズへの寄与はXXH3が突出して大きいため、XXH3を使わないアプリケーションのバイナリーサイズを小さくするのに役立ちます。XXH_NO_LONG_LONG:64ビットのlong long型に依存するアルゴリズムをコンパイル対象から外します。対象にはXXH3とXXH64が含まれ、XXH32だけがコンパイルされます。64ビットに対応しない対象(アーキテクチャやコンパイラー)で役立ちます。XXH_NO_STREAM:ストリーミングAPIを無効にし、ライブラリを1回の呼び出しによるバリアントだけに制限します。XXH_NO_INLINE_HINTS:デフォルトでは、xxHashは__attribute__((always_inline))と__forceinlineを使い、コードサイズを犠牲にして性能を改善します。このマクロを1に定義すると、すべての内部関数をstaticにし、関数をインライン化するかどうかをコンパイラーが決められるようにします。最小のバイナリーサイズを目指す場合に非常に役立ちます。GCCとClangで-O0、-Os、-Oz、-fno-inlineを指定してコンパイルすると、自動的に定義されます。コンパイラーのバージョンによっては、-Ogでコンパイルを成功させるためにも必要です。XXH_SIZE_OPT:0はデフォルトで、速度を最適化します。1は-Osと-Ozでのデフォルトで、サイズ最適化のために速度向上のための一部の工夫を無効にします。2はコードを可能な限り小さくしますが、性能は大きく低下するかもしれません。
XXH3固有のビルド設定
XXH_VECTOR:ベクトル命令セットを手動で選びます(デフォルトではコンパイル時に自動選択)。利用できる命令セットは、XXH_SCALAR、XXH_SSE2、XXH_AVX2、XXH_AVX512、XXH_NEON、XXH_VSXです。正しく対応させるため、コンパイラーが追加のフラグを必要とすることがあります。たとえばx86_64上のgccでは、AVX2に-mavx2、AVX512に-mavx512fが必要です。XXH_PREFETCH_DIST:プリフェッチ距離を選びます。特定のハードウェアプラットフォームに合わせて低水準で調整するための設定です。XXH3だけに適用されます。XXH_NO_PREFETCH:プリフェッチを無効にします。プラットフォームや状況によっては、プリフェッチなしの方が性能がよい場合があります。XXH3だけに適用されます。
xxhsum CLIのビルド設定
XXH_1ST_SPEED_TARGET:ベンチマークモードの最初の速度テストに対して、MiB/sで初期の目標速度を選びます。ベンチマークは以後の反復で目標を調整しますが、最初のテストでは事前に実測せず、この速度を目標にします。現在は、非常に遅い(エミュレーションされた)プラットフォームにも対応するため、控えめな10 MiB/sに設定されています。
Makefileの変数
次の変数は、makeでビルドするときの実行時ディスパッチを制御します。
DISPATCH=1:コマンドラインインターフェースxxhsumでxxh_x86dispatch.cを使い、scalar、sse2、avx2、avx512の命令セットから実行時に選びます。このオプションはx86/x64システムでのみ有効です。x86/x64ターゲットを検出するとデフォルトで有効になります。DISPATCH=0で強制的に無効にできます。LIBXXH_DISPATCH=1:静的ライブラリと動的ライブラリの両方のlibxxhashで、同じ実行時ディスパッチを有効にします。このオプションはx86/x64システムでのみ有効で、デフォルトでは無効です。ライブラリの利用者は短い入力を頻繁にハッシュすると一般に想定されます。その場合はインライン化が重要で、実行時ディスパッチが性能を悪化させる可能性があるため、デフォルトでは無効です。それでも明示的に選ぶことはできます。有効にすると、xxh_x86dispatch.hで宣言されたシンボルがライブラリに含まれ、ヘッダーもインストールされます。アプリケーションは、このヘッダーをインクルードし、XXH3のエントリーポイントをディスパッチ対応版へ転送する必要があります。NODE_JS=1:Emscriptenを使ってNode.js用のxxhsumをコンパイルするとき、ファイルシステムへ制限なくアクセスするためにNODERAWFSライブラリをリンクし、コマンドラインユーティリティが端末を正しく検出できるようにisattyを修正します。この設定により、バイナリーはNode.js専用になります。
ライセンス
ライブラリのファイルxxhash.cとxxhash.hは、BSD 2-Clause Licenseで提供されています。コマンドラインユーティリティxxhsumは、GPLv2で提供されています。
ほかのプログラミング言語
Cの参照実装に加え、多くの貢献者のおかげで、xxHashはさまざまなプログラミング言語から利用できます。xxHashのウェブサイトに一覧があります。
謝辞
- Takayuki Matsuoka(@t-mat):
xxhsum -cの作成と、初期のxxhリリースでの多大な支援に感謝します。 - Mathias Westerdahl(@JCash):
XXH64の初版を導入してくれたことに感謝します。 - Devin Hussey(@easyaspi314):
XXH3とXXH128での優れた低水準最適化に感謝します。