Document Object Model(DOM)は、問い合わせや操作を行うための、JSONのメモリー内表現です。DOMの基本的な使い方はチュートリアルで説明しています。この節では、詳しい内容と応用的な使い方を説明します。
テンプレート
チュートリアルではValueとDocumentを使いました。std::stringと同様、これらは実際にはテンプレートクラスのtypedefです。
これらのテンプレート引数は、独自に指定できます。
エンコーディング
Encoding引数は、メモリー内のJSON文字列値のエンコーディングを指定します。選択肢はUTF8、UTF16、UTF32です。この3つの型もテンプレートクラスです。UTF8<>はUTF8<char>で、文字の保存にcharを使うことを意味します。詳しくはエンコーディングを参照してください。
Windowsアプリケーションで、JSONファイルに保存されたローカライズ用の文字列を問い合わせる場合を考えます。WindowsのUnicode対応関数は、UTF-16(ワイド文字)のエンコーディングを使います。JSONファイルのエンコーディングにかかわらず、メモリー内の文字列をUTF-16で保存できます。
アロケーター
Allocatorは、Document/Valueのメモリーを確保・解放するときに使うアロケータークラスを定義します。DocumentはAllocatorのインスタンスを所有するか参照します。一方、Valueはメモリー消費を減らすため、そうしません。
GenericDocumentで使う既定のアロケーターはMemoryPoolAllocatorです。このアロケーターは、実際にはメモリーを順番に確保し、個別には解放できません。JSONをDOMツリーへ解析する場合に、とても適しています。
別のアロケーターとしてCrtAllocatorがあります。CRTはC RunTime libraryの略です。このアロケーターは、標準のmalloc()/realloc()/free()を呼び出すだけです。追加・削除が多い場合には、こちらが適している場合があります。ただし、効率はMemoryPoolAllocatorより大幅に低くなります。
解析
Documentは、解析用の関数を複数提供します。以下では(1)が基本となる関数で、他は(1)を呼び出す補助関数です。
チュートリアルの例は、通常の文字列解析に(8)を使います。ストリームの例は、最初の3つを使います。In situ解析については、この後で説明します。
parseFlagsは、次のビットフラグの組み合わせです。
| 解析フラグ | 意味 |
|---|---|
| kParseNoFlags | フラグを設定しません。 |
| kParseDefaultFlags | 既定の解析フラグです。マクロRAPIDJSON_PARSE_DEFAULT_FLAGSと同じ値で、このマクロはkParseNoFlagsとして定義されています。 |
| kParseInsituFlag | in situ(破壊的)解析。 |
| kParseValidateEncodingFlag | JSON文字列のエンコーディングの妥当性を検証します。 |
| kParseIterativeFlag | 反復型の解析(関数呼び出しスタックの大きさは一定)。 |
| kParseStopWhenDoneFlag | ストリームから完全なJSONのルートを解析したら、ストリームの残りの処理を停止します。このフラグを使うと、パーサーはkParseErrorDocumentRootNotSingularエラーを発生させません。同じストリームの複数のJSONの解析に使います。 |
| kParseFullPrecisionFlag | 完全な精度で数値を解析します(低速)。このフラグを設定しない場合は、通常の精度(高速)を使います。通常の精度では、誤差は最大3ULPです。 |
| kParseCommentsFlag | 単一行の// ...と複数行の/* ... */のコメントを許可します(緩和されたJSON構文)。 |
| kParseNumbersAsStringsFlag | 数値型の値を文字列として解析します。 |
| kParseTrailingCommasFlag | オブジェクトや配列の末尾のカンマを許可します(緩和されたJSON構文)。 |
| kParseNanAndInfFlag | NaN、Inf、Infinity、-Inf、-Infinityをdouble値として解析することを許可します(緩和されたJSON構文)。 |
関数の引数ではなく非型テンプレート引数を使うことで、C++コンパイラーは指定した組み合わせに最適化したコードを生成できます。これにより速度が向上し、単一の特殊化だけを使う場合にはコードサイズも減ります。一方、フラグをコンパイル時に決める必要があります。
SourceEncoding引数は、ストリームのエンコーディングを定義します。これはDocumentのEncodingと異なっていても構いません。詳しくはエンコーディング変換と妥当性検証の節を参照してください。
InputStreamは入力ストリームの型です。
解析エラー
解析に成功すると、Documentに解析結果が入ります。エラーがある場合、元のDOMは変更されません。解析のエラー状態は、bool HasParseError()、ParseErrorCode GetParseError()、size_t GetParseOffset()で取得できます。
| 解析エラーコード | 説明 |
|---|---|
| kParseErrorNone | エラーなし。 |
| kParseErrorDocumentEmpty | 文書が空です。 |
| kParseErrorDocumentRootNotSingular | 文書のルートの後に、他の値が続いてはいけません。 |
| kParseErrorValueInvalid | 不正な値です。 |
| kParseErrorObjectMissName | オブジェクトのメンバー名がありません。 |
| kParseErrorObjectMissColon | オブジェクトのメンバー名の後に、コロンがありません。 |
| kParseErrorObjectMissCommaOrCurlyBracket | オブジェクトのメンバーの後に、カンマか}がありません。 |
| kParseErrorArrayMissCommaOrSquareBracket | 配列の要素の後に、カンマか]がありません。 |
| kParseErrorStringUnicodeEscapeInvalidHex | 文字列内の\\uエスケープの後に、不正な16進数字があります。 |
| kParseErrorStringUnicodeSurrogateInvalid | 文字列内のサロゲートペアが不正です。 |
| kParseErrorStringEscapeInvalid | 文字列内のエスケープ文字が不正です。 |
| kParseErrorStringMissQuotationMark | 文字列を閉じる引用符がありません。 |
| kParseErrorStringInvalidEncoding | 文字列のエンコーディングが不正です。 |
| kParseErrorNumberTooBig | 数値が大きすぎてdoubleに保存できません。 |
| kParseErrorNumberMissFraction | 数値の小数部がありません。 |
| kParseErrorNumberMissExponent | 数値の指数部がありません。 |
エラーのオフセットは、ストリームの先頭からの文字数として定義されます。現在のRapidJSONは、行番号を追跡しません。
エラーメッセージを取得するために、RapidJSONはrapidjson/error/en.hに英語のメッセージを用意しています。他のロケール向けに変更するか、独自のローカライズシステムを使えます。
解析エラーを処理する例を示します。
in situ解析
Wikipediaより:
In situは、「現場で」や「その位置で」と直訳されるラテン語の語句です。出来事が起こる場所を表す「局所的に」「現場で」「構内で」「その場で」などの意味で、さまざまな文脈に使われます。……(計算機科学では)実行に必要な追加メモリー量がO(1)、つまり入力がどれほど大きくなっても一定量を超えないアルゴリズムを、in situアルゴリズム、またはin-placeアルゴリズムと呼びます。たとえば、ヒープソートはin situのソートアルゴリズムです。
通常の解析では、JSON文字列の復号と他のバッファーへのコピーに大きなオーバーヘッドがあります。In situ解析は、保存されている場所でJSON文字列を復号します。JSONでこれが可能なのは、復号後の文字列の長さが、元のJSON内の長さ以下に必ずなるためです。ここでのJSON文字列の復号とは、"\n"や"\u1234"などのエスケープを処理し、文字列の末尾にヌル終端文字('\0')を加えることです。
以下の図は、通常の解析とin situ解析を比較します。JSON文字列値は、復号した文字列へのポインターを保持します。
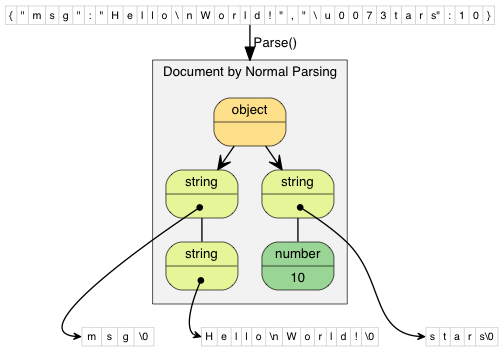
通常の解析では、復号した文字列を新たに確保したバッファーへコピーします。"\\n"(2文字)は"\n"(1文字)に、"\\u0073"(6文字)は"s"(1文字)に復号されます。
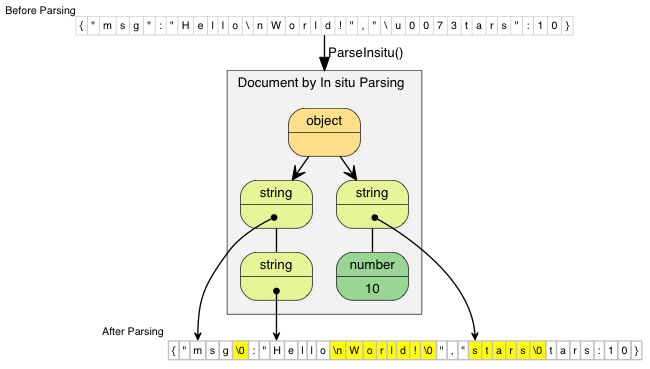
In situ解析は、元のJSONを変更するだけです。変更した文字は図中で強調表示しています。"msg"のようにJSON文字列がエスケープ文字を含まない場合、解析処理は末尾の二重引用符をヌル文字へ置き換えるだけです。
in situ解析は入力を変更するため、解析APIはconst char*ではなくchar*を必要とします。
JSON文字列はconst-stringとして扱われますが、実際には「不変」とは限りません。その寿命はJSONバッファーに依存します。
in situ解析は、メモリー確保のオーバーヘッドとコピーを最小化します。一般に、これによりキャッシュの一貫性が改善します。これは、現代のコンピューターの性能で重要な要因です。
in situ解析には、いくつかの制限があります。
- JSON全体がメモリー内にある必要があります。
- ストリームの入力エンコーディングと文書の変換先エンコーディングが同じでなければなりません。
- 文書を使わなくなるまで、バッファーを保持する必要があります。
- 解析後にDOMを長期間使い、DOM内のJSON文字列が少ない場合には、バッファーを保持することがメモリーの無駄になる場合があります。
In situ解析は主に、一度だけ処理してメモリーから解放する、短期間使うJSONに適しています。実際には、このような場面はよくあります。たとえば、JSONからC++オブジェクトへのデシリアライズや、JSONで表されたウェブリクエストの処理などです。
エンコーディング変換と妥当性検証
RapidJSONは、Unicode形式(正式にはUCS Transformation Format)間の変換を内部で処理します。DOMの解析中、ストリームの入力エンコーディングはDOMのエンコーディングと異なっていても構いません。たとえば、入力ストリームのJSONはUTF-8でも、DOMはUTF-16にできます。EncodedInputStreamにコード例があります。
DOMから出力ストリームへJSONを書き込む場合にも、エンコーディング変換を使えます。EncodedOutputStreamに例があります。
エンコーディング変換では、まず入力文字列をUnicodeコードポイントへ復号し、次にコードポイントを変換先の形式へ符号化します。復号時には、入力文字列のバイト列の妥当性を検証します。不正な列であれば、パーサーはkParseErrorStringInvalidEncodingエラーで停止します。
ストリームの入力エンコーディングがDOMのエンコーディングと同じ場合、既定ではパーサーは列の妥当性検証を行いません。kParseValidateEncodingFlagを使えば、強制的に検証できます。
テクニック
DOM APIを使うためのテクニックを説明します。
SAXイベントの発行元としてのDOM
RapidJSONでWriterを使ってDOMを文字列化する方法は、少し奇妙に見えるかもしれません。
実際には、Value::Accept()が値に関するSAXイベントをハンドラーへ発行します。この設計により、ValueとWriterは切り離されています。ValueはSAXイベントを生成でき、Writerはそれらを処理できます。
DOMを他の形式へ変換するための、独自のハンドラーを作れます。たとえば、DOMをXMLへ変換するハンドラーなどです。
SAXイベントとハンドラーの詳しい説明は、SAXを参照してください。
利用者のバッファー
メモリーの確保を、可能な限り避けたいアプリケーションもあります。
MemoryPoolAllocatorは、利用者がバッファーを指定することで、これに対応します。バッファーは、プログラムのスタック上に置いたり、一時データを保存するために静的に確保した「スクラッチバッファー」(static配列やグローバル配列)にしたりできます。
MemoryPoolAllocatorは利用者のバッファーからメモリーを確保します。そのバッファーを使い切ると、基底アロケーター(既定ではCrtAllocator)からメモリーの塊を確保します。
スタックメモリーを使う例を示します。第1のアロケーターは値の保存用、第2のアロケーターは解析中の一時データの保存用です。
解析中に確保する合計量が4096+1024バイト未満なら、このコードはnewやmalloc()によるヒープ上のメモリー確保を一度も行いません。
MemoryPoolAllocator::Size()で、現在のメモリー消費量をバイト単位で問い合わせられます。それにより、利用者のバッファーに適した大きさを決められます。