このチュートリアルでは、Document Object Model(DOM)APIの基本を紹介します。
使い方の概要で示したように、JSONをDOMへ解析し、DOMへ簡単に問い合わせや変更を行い、最後にJSONへ戻せます。
ValueとDocument
各JSON値は、Valueという型に保存します。DOMを表すDocumentは、DOMツリーのルートとなるValueを保持します。RapidJSONの公開型と公開関数はすべて、rapidjson名前空間に定義されています。
値の問い合わせ
この節では、example/tutorial/tutorial.cppの抜粋を使います。
C文字列(const char* json)にJSONを保存したとします。
これをDocumentへ解析します。
JSONは、DOMツリーとしてdocumentへ解析されました。
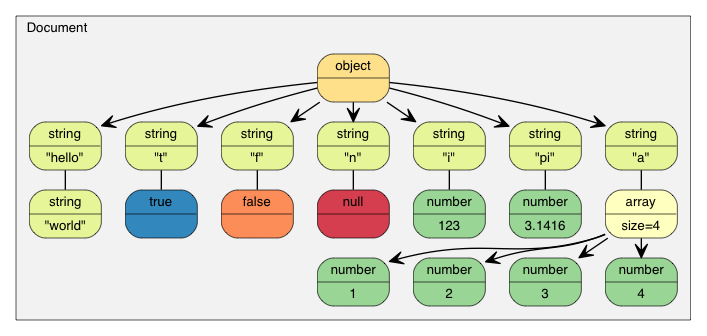
RFC 7159への更新以降、準拠するJSON文書のルートには、どのJSON値でも使えます。それ以前のRFC 4627では、ルート値にはオブジェクトか配列しか使えませんでした。この例のルートはオブジェクトです。
ルートオブジェクトに"hello"メンバーがあるか問い合わせてみます。Valueは異なる型の値を保持できるため、型を確認し、適切なAPIで値を取得する必要がある場合があります。この例では、"hello"メンバーはJSON文字列に対応しています。
JSONのtrue/false値は、boolで表します。
JSONのnullは、IsNull()で問い合わせられます。
JSONの数値型は、すべての数値を表します。ただし、C++で操作するには、より具体的な型が必要です。
JSON配列は、複数の要素を保持します。
RapidJSONは、JSONの型の間で値を自動変換しません。たとえば、値が文字列なら、GetInt()の呼び出しは不正です。デバッグモードではアサーションに失敗し、リリースモードでは未定義の動作になります。
以下では、個々の型に問い合わせる方法を詳しく説明します。
配列の問い合わせ
既定では、SizeTypeはunsignedのtypedefです。大半のシステムでは、配列が保存できる要素数は最大2^32-1に制限されます。
a[0]、a[1]、a[2]など、整数リテラルで配列の要素へアクセスできます。
配列はstd::vectorと同様、インデックスの代わりにイテレーターを使って、すべての要素へアクセスすることもできます。
他にも、よく使う問い合わせ関数があります。
- SizeType Capacity() const
- bool Empty() const
範囲ベースのforループ(v1.1.0で追加)
C++11が有効なら、範囲ベースのforループで配列内のすべての要素へアクセスできます。
オブジェクトの問い合わせ
配列と同様、イテレーターですべてのオブジェクトメンバーへアクセスできます。
operator[](const char*)でメンバーが見つからないと、アサーションに失敗することに注意してください。
メンバーが存在するか不明な場合は、operator[](const char*)の前にHasMember()を呼ぶ必要があります。ただし、これでは検索を2回行います。FindMember()を呼べば、メンバーの存在確認と値の取得を一度に行えるため、より良い方法です。
範囲ベースのforループ(v1.1.0で追加)
C++11が有効なら、範囲ベースのforループでオブジェクト内のすべてのメンバーへアクセスできます。
数値の問い合わせ
JSONには、Numberという単一の数値型があります。Numberは整数か実数を表せます。RFC 4627では、Numberの範囲はパーサーが定めるとしています。
C++には複数の整数型と浮動小数点型があるため、DOMはできるだけ広い範囲と良い性能で、これらを扱おうとします。
Numberを解析すると、DOMでは以下のいずれかの型で保存します。
| 型 | 説明 |
|---|---|
| unsigned | 32ビットの符号なし整数 |
| int | 32ビットの符号付き整数 |
| uint64_t | 64ビットの符号なし整数 |
| int64_t | 64ビットの符号付き整数 |
| double | 64ビットの倍精度浮動小数点数 |
数値へ問い合わせるときは、その数値を対象の型として取得できるか確認できます。
| 確認 | 取得 |
|---|---|
| bool IsNumber() | 該当なし |
| bool IsUint() | unsigned GetUint() |
| bool IsInt() | int GetInt() |
| bool IsUint64() | uint64_t GetUint64() |
| bool IsInt64() | int64_t GetInt64() |
| bool IsDouble() | double GetDouble() |
整数値は、変換せずに複数の方法で取得できる場合があります。たとえば、123を保持する値xでは、x.IsInt() == x.IsUint() == x.IsInt64() == x.IsUint64() == trueとなります。一方、-3000000000を保持する値yでは、x.IsInt64() == trueだけが成立します。
数値を取得するとき、GetDouble()は内部の整数表現をdoubleへ変換します。intとunsignedはdoubleへ安全に変換できますが、int64_tとuint64_tでは精度を失う場合があります(doubleの仮数部は52ビットしかないためです)。
文字列の問い合わせ
Valueクラスには、GetString()に加えてGetStringLength()もあります。その理由を説明します。
RFC 4627によると、JSON文字列にはUnicode文字U+0000を含めることができ、"\u0000"としてエスケープしなければなりません。問題は、C/C++ではヌル終端文字列をよく使い、\0'を終端記号として扱うことです。
RFC 4627に準拠するため、RapidJSONはU+0000を含む文字列に対応しています。これを扱う必要がある場合は、GetStringLength()APIで正しい文字列長を取得できます。
たとえば、以下のJSONをDocument dへ解析した場合です。
値"a\u0000b"の正しい長さは3ですが、strlen()は1を返します。
バッファーの確保のためにstrlen()を呼ぶことが多いため、GetStringLength()は性能の改善にも役立ちます。
さらに、std::stringには次のコンストラクターもあります。
これは、引数として文字列の長さを受け取ります。文字列内のヌル文字の保存にも対応し、性能の向上も期待できます。
値の比較
値の比較には、==と!=を使えます。2つの値が等しいのは、型と内容がともに同じ場合に限ります。プリミティブ型とも比較できます。例を示します。
配列やオブジェクトは、要素やメンバーを順番に比較します。部分ツリー全体が等しい場合に限り、等しいと判定されます。
現時点では、オブジェクトに名前が重複するメンバーがあると、どのオブジェクトとの等価比較も常にfalseとなることに注意してください。
値の作成・変更
値を作る方法はいくつかあります。DOMツリーを作成・変更した後は、Writerで再びJSONとして保存できます。
値の型の変更
既定のコンストラクターでValueやDocumentを作ると、型はNullになります。型を変更するには、SetXXX()か代入演算子を使います。たとえば、次のようになります。
オーバーロードされたコンストラクター
複数の型について、オーバーロードされたコンストラクターもあります。
空のオブジェクトや配列を作るには、既定のコンストラクターの後にSetObject()/SetArray()を使うか、Value(Type)で一度に作れます。
ムーブセマンティクス
RapidJSONの設計で特徴的な決定は、値の代入で、代入元を代入先へコピーしないことです。代わりに、代入元の値を代入先へ移動します。たとえば、次のようになります。
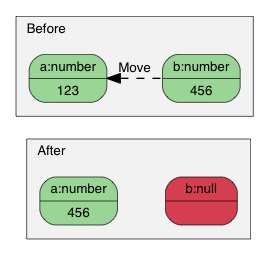
なぜでしょうか。このセマンティクスの利点は何でしょうか。
簡単に言えば、性能のためです。大きさが固定のJSON型(Number、True、False、Null)は、高速かつ簡単にコピーできます。しかし、可変長のJSON型(String、Array、Object)では、コピーに大きなオーバーヘッドが生じます。このオーバーヘッドは見落とされがちです。特に、一時オブジェクトを作り、別の変数へコピーし、破棄する場合に発生します。
たとえば、通常のコピーセマンティクスを使った場合です。
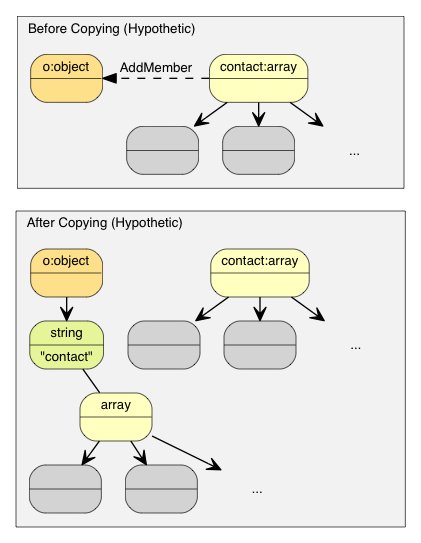
オブジェクトoは、contactsと同じ大きさのバッファーを確保し、ディープコピーを作る必要があります。その後、最後にcontactsが破棄されます。これにより、不要なメモリー確保・解放やコピーが大量に発生します。
参照カウントやガベージコレクション(GC)など、実際にこれらのデータをコピーせずに済ませる方法もあります。
RapidJSONを単純かつ高速にするため、代入にはムーブセマンティクスを採用しました。代入時に所有権を移すstd::auto_ptrに似ています。ムーブはずっと高速で単純です。元の値を破棄し、memcpy()で代入元を代入先へコピーし、最後に代入元をNull型にするだけです。
ムーブセマンティクスを使うと、上の例は次のようになります。
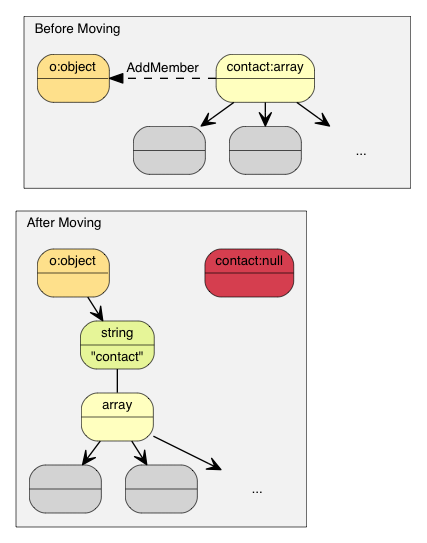
これは、C++11ではムーブ代入演算子と呼ばれます。RapidJSONはC++03に対応しているため、代入演算子と、AddMember()やPushBack()など他のすべての変更用関数にムーブセマンティクスを採用しています。
ムーブセマンティクスと一時値
PushBack()やAddMember()などの「移動する」関数へ渡す前に、その場でValueを作ると便利な場合があります。一時オブジェクトは適切なValueの参照へ変換できないため、補助関数Move()が用意されています。
文字列の作成
RapidJSONは、文字列の保存に2つの方法を提供します。
- copy-string:バッファーを確保して、元のデータをコピーします。
- const-string:文字列へのポインターだけを保存します。
copy-stringはデータのコピーを所有するため、常に安全です。const-stringは、文字列リテラルの保存と、Documentの節で説明するin-situ解析に使えます。
メモリー確保を独自に扱えるよう、RapidJSONでは、メモリー確保が必要になり得る操作には、アロケーターのインスタンスを渡す必要があります。この設計は、Valueごとにアロケーター(またはDocument)へのポインターを保存しないために必要です。
そのため、copy-stringを代入するときは、アロケーター付きの、オーバーロードされたSetString()を呼びます。
この例では、Documentのインスタンスからアロケーターを取得します。これは、RapidJSONでよく使う書き方ですが、別のアロケーターのインスタンスを使うこともできます。
上のSetString()には長さも必要です。そのため、文字列内のヌル文字も扱えます。長さ引数のない別のSetString()のオーバーロードもあります。そちらは入力がヌル終端されていると仮定し、strlen()のような関数で長さを取得します。
最後に、文字列リテラルや寿命が保証される文字列には、アロケーター引数のないconst-string版のSetString()を使えます。文字列リテラル(または定数の文字配列)なら、引数としてそのまま渡すだけで安全かつ効率的です。
文字ポインターをコピーせずに使うには、RapidJSONでは安全なものとして明示する必要があります。これは、StringRef関数で行えます。
配列の変更
配列型のValueは、std::vectorに似たAPIを提供します。
- Clear()
- Reserve(SizeType, Allocator&)
- Value& PushBack(Value&, Allocator&)
- template <typename T> GenericValue& PushBack(T, Allocator&)
- Value& PopBack()
- ValueIterator Erase(ConstValueIterator pos)
- ValueIterator Erase(ConstValueIterator first, ConstValueIterator last)
Reserve(...)とPushBack(...)は、配列要素用のメモリーを確保する場合があるため、アロケーターが必要です。
PushBack()の例を示します。
STLと異なり、PushBack()/PopBack()は配列自身の参照を返します。これを流暢なインターフェースと呼びます。
配列に、定数ではない文字列や寿命が十分でない文字列(文字列の作成を参照)を追加するには、copy-string APIで文字列のValueを作る必要があります。中間変数を用意せずに、その場で一時値を使うこともできます。
オブジェクトの変更
オブジェクトは、キーと値の組(メンバー)の集合です。キーはすべて文字列値でなければなりません。変更するには、メンバーを追加・削除します。以下は、メンバーの追加用APIです。
- Value& AddMember(Value&, Value&, Allocator& allocator)
- Value& AddMember(StringRefType, Value&, Allocator&)
- template <typename T> Value& AddMember(StringRefType, T value, Allocator&)
例を示します。
StringRefTypeによる名前の引数は、文字列値用のSetString関数のインターフェースに似ています。JSONオブジェクトでは定数のキー名をよく使うため、これらのオーバーロードによってname文字列のコピーを避けられます。
定数ではない文字列や寿命が十分でない文字列(文字列の作成を参照)から名前を作るには、copy-string APIで文字列のValueを作る必要があります。中間変数を用意せずに、その場で一時値を使うこともできます。
メンバーの削除には、いくつかの方法があります。
- bool RemoveMember(const Ch* name):名前を検索してメンバーを削除します(時間計算量は線形)。
- bool RemoveMember(const Value& name):上と同じですが、nameはValueです。
- MemberIterator RemoveMember(MemberIterator):イテレーターでメンバーを削除します(時間計算量は定数)。
- MemberIterator EraseMember(MemberIterator):上に似ていますが、メンバーの順序を保持します(時間計算量は線形)。
- MemberIterator EraseMember(MemberIterator first, MemberIterator last):範囲内のメンバーを削除し、順序を保持します(時間計算量は線形)。
MemberIterator RemoveMember(MemberIterator)は、「move-last」という方法で定数時間を実現します。基本的には、イテレーター位置のメンバーを破棄し、最後の要素をその位置へ移動します。そのため、残ったメンバーの順序が変わります。
値のディープコピー
DOMツリーを実際にコピーする必要がある場合は、アロケーター付きのコンストラクターとCopyFrom()という2つのAPIでディープコピーできます。
値の交換
Swap()も用意されています。
2つのDOMツリーは、ツリーの複雑さにかかわらず、高速(定数時間)に交換できます。
次に読むもの
このチュートリアルでは、DOMツリーへの問い合わせと操作の基本を示しました。RapidJSONには、他にも重要な概念があります。
- ストリームはJSONを読み書きする経路で、メモリー内の文字列やファイルストリームなどがあります。独自のストリームも作れます。
- エンコーディングは、ストリームやメモリーで使う文字エンコーディングを定義します。RapidJSONは、Unicodeの変換と妥当性検証も内部で処理します。
- DOMの基本は、このチュートリアルで説明しました。in situ解析やその他の解析オプション、応用的な使い方などを学べます。
- SAXは、RapidJSONの解析・生成機能の基盤です。Reader/Writerでさらに高速なアプリケーションを実装する方法を学べます。また、PrettyWriterによるJSONの整形も試してください。
- 性能では、開発元と第三者によるベンチマークを紹介します。
- 内部設計では、RapidJSON内部の設計やテクニックを説明します。
FAQ、API文書、サンプル、単体テストも参照できます。