この節では、設計と実装の詳細を記録します。
アーキテクチャー
SAXとDOM
SAXとDOMの基本的な関係を、次のUML図に示します。
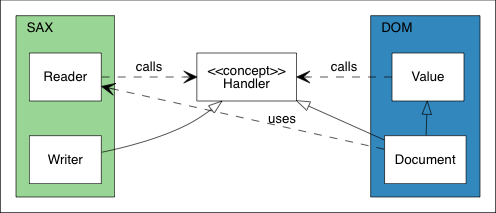
関係の中心は、Handlerという概念です。SAX側では、ReaderがストリームからJSONを解析し、Handlerへイベントを発行します。WriterはHandlerの概念を実装し、同じイベント群を処理します。DOM側では、DocumentがHandlerの概念を実装して、イベントに従ってDOMを構築します。Valueには、DOMを走査してイベントを発行するValue::Accept(Handler&)関数があります。
この設計により、SAXはDOMに依存しません。ReaderとWriterの間にも依存関係はありません。そのため、イベントの発行元とハンドラーを柔軟につなげられます。また、ValueもSAXに依存しません。したがって、DOMをJSONへ文字列化するだけでなく、XMLライターへ出力したり、ほかの処理を行ったりすることもできます。
ユーティリティークラス
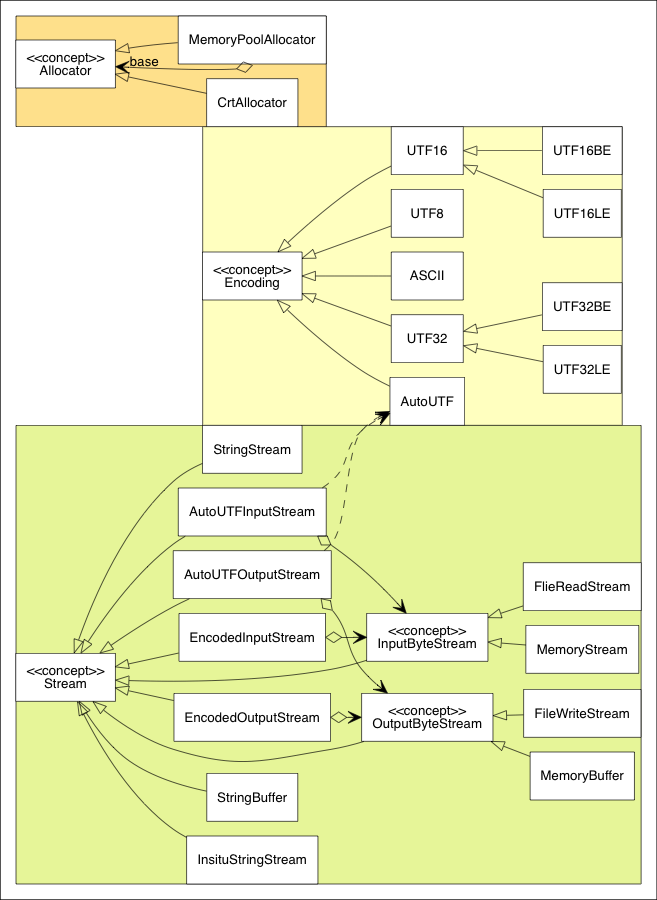
SAXとDOMの両APIは、さらにAllocator、Encoding、Streamという3つの概念に依存します。その継承階層を以下に示します。
Value
Value(実際にはGenericValue<UTF8<>>のtypedef)は、DOM APIの中心です。この節では、その設計を説明します。
データ配置
Valueはバリアント型です。RapidJSONでは、Valueのインスタンスは、6種類のJSON値の型のうち一つを保持できます。これはunionで実現しています。各Valueは、union Data data_とunsigned flags_という2つのメンバーを持ちます。flags_は、JSONの型と追加情報を表します。
以下の表は、各型のデータ配置を示します。32ビット・64ビットの列は、フィールドの大きさをバイト単位で表します。
| Null | 32ビット | 64ビット | |
|---|---|---|---|
| (未使用) | 4 | 8 | |
| (未使用) | 4 | 4 | |
| (未使用) | 4 | 4 | |
| unsigned flags_ | kNullType kNullFlag | 4 | 4 |
| Bool | 32ビット | 64ビット | |
|---|---|---|---|
| (未使用) | 4 | 8 | |
| (未使用) | 4 | 4 | |
| (未使用) | 4 | 4 | |
| unsigned flags_ | kBoolType(kTrueFlagまたはkFalseFlag) | 4 | 4 |
| String | 32ビット | 64ビット | |
|---|---|---|---|
| Ch* str | 文字列へのポインター(所有する場合あり) | 4 | 8 |
| SizeType length | 文字列長 | 4 | 4 |
| (未使用) | 4 | 4 | |
| unsigned flags_ | kStringType kStringFlag ... | 4 | 4 |
| Object | 32ビット | 64ビット | |
|---|---|---|---|
| Member* members | メンバー配列へのポインター(所有) | 4 | 8 |
| SizeType size | メンバー数 | 4 | 4 |
| SizeType capacity | メンバーの容量 | 4 | 4 |
| unsigned flags_ | kObjectType kObjectFlag | 4 | 4 |
| Array | 32ビット | 64ビット | |
|---|---|---|---|
| Value* values | 値の配列へのポインター(所有) | 4 | 8 |
| SizeType size | 値の数 | 4 | 4 |
| SizeType capacity | 値の容量 | 4 | 4 |
| unsigned flags_ | kArrayType kArrayFlag | 4 | 4 |
| Number (Int) | 32ビット | 64ビット | |
|---|---|---|---|
| int i | 32ビットの符号付き整数 | 4 | 4 |
| (ゼロ埋め) | 0 | 4 | 4 |
| (未使用) | 4 | 8 | |
| unsigned flags_ | kNumberType kNumberFlag kIntFlag kInt64Flag ... | 4 | 4 |
| Number (UInt) | 32ビット | 64ビット | |
|---|---|---|---|
| unsigned u | 32ビットの符号なし整数 | 4 | 4 |
| (ゼロ埋め) | 0 | 4 | 4 |
| (未使用) | 4 | 8 | |
| unsigned flags_ | kNumberType kNumberFlag kUIntFlag kUInt64Flag ... | 4 | 4 |
| Number (Int64) | 32ビット | 64ビット | |
|---|---|---|---|
| int64_t i64 | 64ビットの符号付き整数 | 8 | 8 |
| (未使用) | 4 | 8 | |
| unsigned flags_ | kNumberType kNumberFlag kInt64Flag ... | 4 | 4 |
| Number (Uint64) | 32ビット | 64ビット | |
|---|---|---|---|
| uint64_t i64 | 64ビットの符号なし整数 | 8 | 8 |
| (未使用) | 4 | 8 | |
| unsigned flags_ | kNumberType kNumberFlag kInt64Flag ... | 4 | 4 |
| Number (Double) | 32ビット | 64ビット | |
|---|---|---|---|
| uint64_t i64 | 倍精度浮動小数点数 | 8 | 8 |
| (未使用) | 4 | 8 | |
| unsigned flags_ | kNumberType kNumberFlag kDoubleFlag | 4 | 4 |
補足:
- 64ビットアーキテクチャーでのメモリー使用量を減らすため、SizeTypeはsize_tではなくunsignedのtypedefになっています。
- 32ビット数値のゼロ埋めは、エンディアンに応じて実際の型の前か後に置かれます。これにより、変換せずに32ビット整数を64ビット整数として解釈できます。
- Intは常にInt64でもありますが、その逆は常に成り立つわけではありません。
フラグ
32ビットのflags_には、JSONの型と追加情報が含まれます。上の表に示すように、各JSON型は、重複するkXXXTypeとkXXXFlagを持ちます。この設計は、ビットフラグの検査(IsNumber())と、各型の連番の取得(GetType())を最適化するためのものです。
Stringには、2つの任意のフラグがあります。kCopyFlagは、文字列のコピーを所有することを表します。kInlineStrFlagは、短い文字列の最適化を使うことを表します。
Numberは、少し複雑です。通常の整数値は、その範囲に応じて、kIntFlag、kUintFlag、kInt64Flag、kUint64Flagのフラグの一つまたは複数を持てます。小数部のある数値や64ビットの範囲を超える整数は、kDoubleFlagを付けたdoubleとして保存します。
短い文字列の最適化
Kostaが、優れた短い文字列の最適化を提供しました。考え方は次のとおりです。flags_を除くと、Valueには実データ保存用に12または16バイト(32ビットまたは64ビット)があります。文字列へのポインターを保存する代わりに、この領域へ短い文字列を直接保存できます。1バイトの文字型(charなど)を使うエンコーディングでは、Valueの内部に最大11または15文字の文字列を保存できます。
| ShortString (Ch=char) | 32ビット | 64ビット | |
|---|---|---|---|
| Ch str[MaxChars] | 文字列バッファー | 11 | 15 |
| Ch invLength | MaxChars - Length | 1 | 1 |
| unsigned flags_ | kStringType kStringFlag ... | 4 | 4 |
特別な手法を使っています。文字列長を直接保存する代わりに、(MaxChars - length)を保存します。これにより、末尾に\0を付けた11文字の文字列を保存できます。
この最適化は、copy-stringのメモリー使用量を減らせます。また、キャッシュコヒーレンスを改善し、実行時の性能も改善できます。
Allocator
Allocatorは、RapidJSONにおける概念です。
Malloc()とRealloc()はメンバー関数ですが、Free()は静的メンバー関数であることに注意してください。
MemoryPoolAllocator
MemoryPoolAllocatorは、DOMの既定のアロケーターです。メモリーを確保しますが、解放はしません。DOMツリーの構築に適しています。
内部では、基底のアロケーター(既定はCrtAllocator)からメモリーのチャンクを確保し、単方向連結リストとして保存します。利用者がメモリー確保を要求すると、次の順番で確保します。
- 利用者が指定したバッファーがあれば、それを使います(DOMの「利用者が指定するバッファー」の節を参照)。
- 利用者が指定したバッファーが満杯なら、現在のメモリーチャンクを使います。
- 現在のブロックが満杯なら、新しいメモリーブロックを確保します。
解析の最適化
SIMDによる空白の読み飛ばし
ストリームからJSONを解析する際、パーサーは次の4つの空白文字を読み飛ばす必要があります。
- 空白(U+0020)
- 水平タブ(U+000B)
- 改行(U+000A)
- 復帰(U+000D)
単純に実装すると、次のようになります。
ただし、これでは文字ごとに4回の比較と複数の分岐が必要です。この部分が処理のホットスポットであることが分かりました。
処理を高速化するため、SIMDを使って、反復ごとに16文字を4つの空白文字と比較します。現在、RapidJSONでは、この処理にSSE2とSSE4.2命令だけをサポートしています。有効になるのは、文字列ストリームやin situ解析など、UTF-8のメモリーストリームだけです。
この最適化を有効にするには、rapidjson.hをインクルードする前にRAPIDJSON_SSE2かRAPIDJSON_SSE42を定義します。コンパイラーによっては、perftest.hの例のように設定を検出できます。
これらはコンパイル時の設定です。該当する命令セットをサポートしないマシンで実行ファイルを動かすと、クラッシュすることに注意してください。
ページ境界の問題
RapidJSONの初期版では、SkipWhitespace_SIMD()がごくまれに(約50万回に1回)クラッシュすることが、問題報告で報告されました。調査の結果、_mm_loadu_si128()が'\0'の後のバイトへアクセスし、保護されたページ境界を越えることが原因と疑われました。
Intel® 64 and IA-32 Architectures Optimization Reference Manualの10.2.1節には、次の記述があります。
アラインされていない128ビットSIMDメモリーアクセスを必要とするアルゴリズムをサポートするには、呼び出し側の関数でメモリーバッファーを確保する際、呼び出される関数がアドレスポインターを使ってそのようなアクセスを安全に行えるよう、パディング領域の追加を検討する必要があります。最小のパディングサイズは、アラインされていないSIMDメモリーアクセスで使う可能性があるSIMDレジスターの幅です。
RapidJSONは、このような要件を強制すべきではないため、この方法は実用的ではありません。
この問題を修正するため、現在の処理では、次のアラインされたアドレスまでバイトを処理します。その後、アラインされた読み取りでSIMD処理を行います。#85も参照してください。
ストリームのローカルコピー
最適化中に、一部のコンパイラーが、ストリームのメンバーデータへのアクセスをローカル変数やレジスターへ移せないことが分かりました。実験では、ストリームの型によっては、ストリームをコピーして内部ループで使うと性能が改善しました。たとえば、実際の(SIMDを使わない)SkipWhitespace()は、次のように実装されています。
ストリームの特性に応じて、StreamLocalCopyはストリームオブジェクトをコピーするかを決め、それをローカルで使い、ストリームの状態を元のストリームへ書き戻します。
doubleへの解析
文字列をdoubleへ解析するのは難しい処理です。標準ライブラリーのstrtod()でも行えますが、低速です。既定では、パーサーは通常精度の設定を使います。最大誤差は3 ULPで、internal::StrtodNormalPrecision()に実装されています。
kParseFullPrecisionFlagを使うと、パーサーは代わりにinternal::StrtodFullPrecision()を呼びます。この関数には、実際に3種類の変換方法が実装されています。
- Fast-Path。
- double-conversionにあるような、独自のDIY-FP実装。
- Clinger, William D.「How to read floating point numbers accurately」(Vol. 25, No. 6, ACM, 1990)にあるような、大整数による方法。
最初の変換方法で失敗した場合は2番目を試し、以降も同様に進めます。
生成の最適化
整数から文字列への変換
素朴な整数から文字列への変換アルゴリズムでは、十進数の各桁で除算を行います。さまざまな実装を作り、itoa-benchmarkで評価しました。
SSE2版が最も高速ですが、2番目のbranchlutとの差はわずかです。branchlutは純粋なC++実装なので、RapidJSONではbranchlutを採用しました。
doubleから文字列への変換
当初、RapidJSONは、doubleから文字列への変換にsnprintf(..., ..., "%g")を使っていました。既定の精度が6なので、これは正確ではありません。後に、低速であることや代わりの方法があることも分かりました。
GoogleのV8のdouble-conversionには、Grisu3という新しい高速なアルゴリズムが実装されています(Loitsch, Florian. "Printing floating-point numbers quickly and accurately with integers." ACM Sigplan Notices 45.6 (2010): 233–243)。
ただし、ヘッダーだけの実装ではないため、Grisu2のヘッダーだけの版を実装しました。このアルゴリズムは、結果が常に正確であることを保証します。また、大半の場合に、最短(最適)の文字列表現を生成します。
ヘッダーだけの変換関数は、dtoa-benchmarkで評価されています。
パーサー
反復型パーサー
反復型パーサーは、再帰を使わずに実装した、再帰下降LL(1)パーサーです。
文法
このパーサーの文法は、厳密なJSON構文に基づきます。
文法をLL(1)にするため、非終端記号valuesとmembersを左因子分解していることに注意してください。
解析表
この文法に基づき、FIRST集合とFOLLOW集合を構築できます。
非終端記号のFIRST集合を以下に示します。
| 非終端記号 | FIRST |
|---|---|
| array | [ |
| object | { |
| values | ε STRING NUMBER NULL BOOLEAN { [ |
| addition-values | ε COMMA |
| members | ε STRING |
| addition-members | ε COMMA |
| member | STRING |
| value | STRING NUMBER NULL BOOLEAN { [ |
| S | [ { |
| non-empty-members | STRING |
| non-empty-values | STRING NUMBER NULL BOOLEAN { [ |
FOLLOW集合を以下に示します。
| 非終端記号 | FOLLOW |
|---|---|
| S | $ |
| array | , $ } ] |
| object | , $ } ] |
| values | ] |
| non-empty-values | ] |
| addition-values | ] |
| members | } |
| non-empty-members | } |
| addition-members | } |
| member | , } |
| value | , } ] |
最後に、FIRST集合とFOLLOW集合から解析表を構築できます。
| 非終端記号 | [ | { | , | : | ] | } | STRING | NUMBER | NULL | BOOLEAN |
|---|---|---|---|---|---|---|---|---|---|---|
| S | array | object | ||||||||
| array | [ values ] | |||||||||
| object | { members } | |||||||||
| values | non-empty-values | non-empty-values | ε | non-empty-values | non-empty-values | non-empty-values | non-empty-values | |||
| non-empty-values | value addition-values | value addition-values | value addition-values | value addition-values | value addition-values | value addition-values | ||||
| addition-values | , non-empty-values | ε | ||||||||
| members | ε | non-empty-members | ||||||||
| non-empty-members | member addition-members | |||||||||
| addition-members | , non-empty-members | ε | ||||||||
| member | STRING : value | |||||||||
| value | array | object | STRING | NUMBER | NULL | BOOLEAN |
上の文法の解析に役立つツールがあります。
実装
解析表に基づき、生成規則を展開する際に規則の本体を逆順でスタックへ積む、直接的な(従来の)実装を使えます。
RapidJSONでは、直接的な実装にいくつかの変更(現在の設計への適応)を加えています。
まず、RapidJSONでは、解析表を状態機械として符号化します。状態は生成規則の左辺と右辺から、状態遷移は生成規則から構築します。さらに、arrayとobjectを含む生成規則には、追加の状態を設けます。これにより、直接的な実装で複数回のpop/push操作を行う代わりに、配列の値やオブジェクトのメンバーの生成を一つの状態遷移で行えます。スタックサイズの見積もりも簡単になります。
状態図を以下に示します。
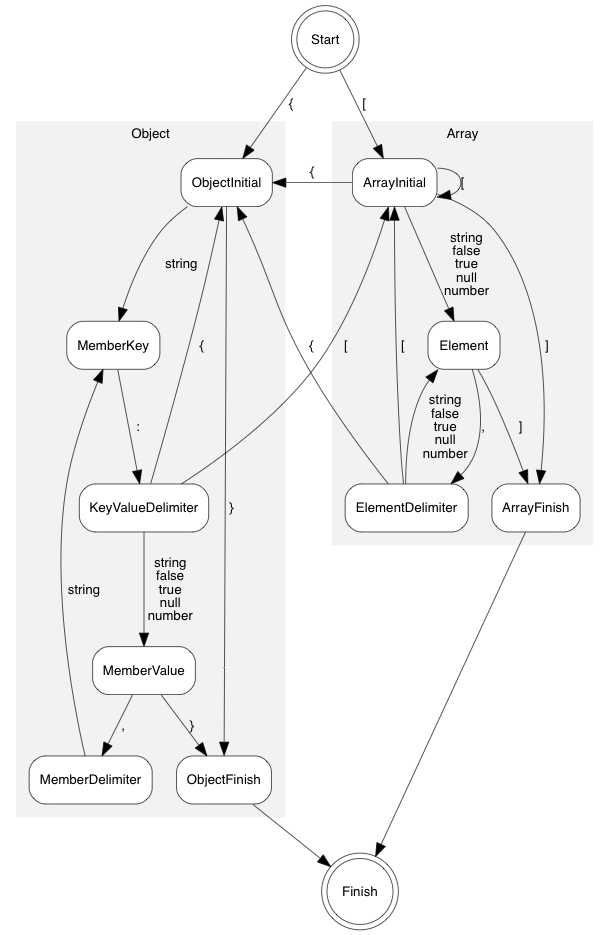
次に、反復型パーサーは、内部スタックで配列の値の数とオブジェクトのメンバー数も管理します。これは、従来の実装とは異なる場合があります。